Introduction
Il y a quelques mois, j’ai créé six VM sur Proxmox pour construire mon premier cluster Kubernetes. Terraform a créé les machines, mais j’ai préparé les nœuds manuellement, comme je l’expliquais dans cet article précédent.
C’était volontaire. Je voulais comprendre les étapes de préparation et de bootstrap avant de les automatiser.
ℹ️ Je travaille maintenant sur la migration de Docker Compose vers Kubernetes, et je veux automatiser le déploiement des VM et la préparation des nœuds. Pour l’instant, le bootstrap du cluster restera manuel, comme prévu dans la feuille de route.
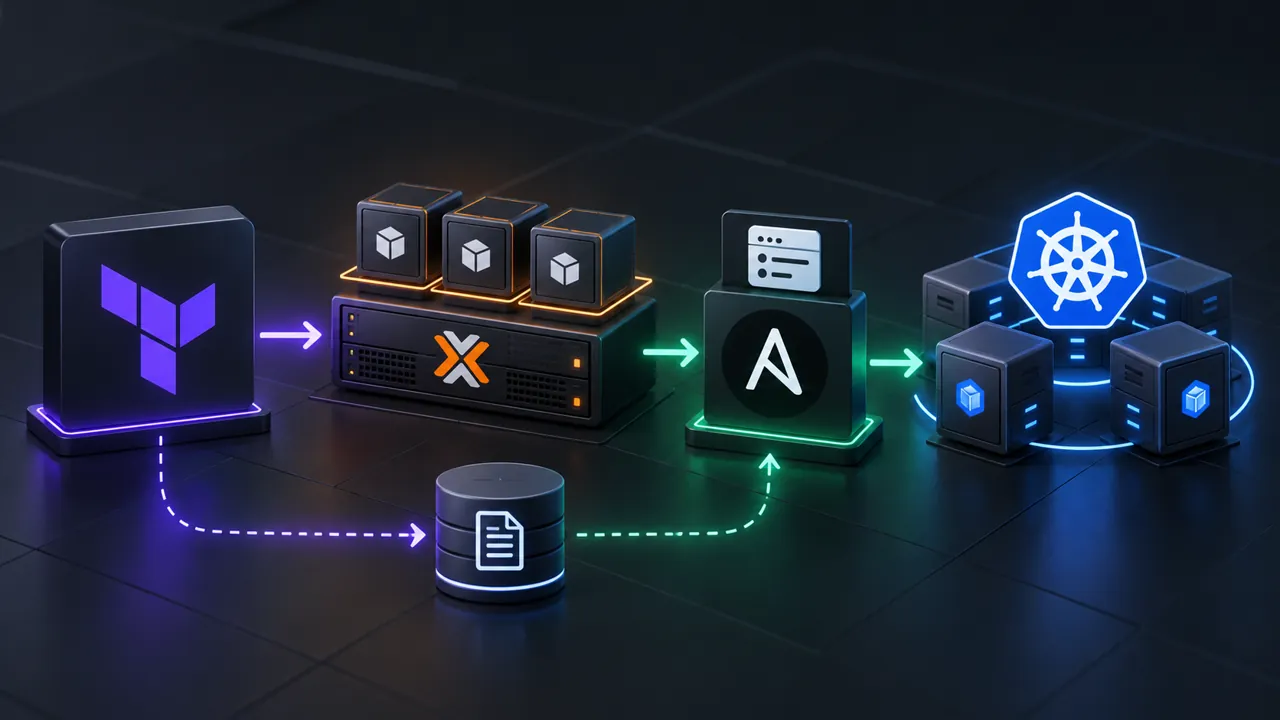
🎯 L’objectif de ce projet est d’obtenir des VM prêtes pour Kubernetes, créées avec Terraform et configurées avec Ansible. J’exécute les deux via Semaphore UI, et l’état Terraform fournit l’inventaire à Ansible.
Un projet Terraform dédié
Je crée un nouveau projet Terraform appelé kubernetes_vms, basé sur le travail déjà réalisé dans terransible. Il réutilise mon module pve_vm existant, présenté dans cet article.
Le déploiement précédent créait un master et un worker sur chaque nœud Proxmox. Cette fois, j’utilise master_count et worker_count pour définir le nombre de VM souhaité pour chaque rôle. Le nombre de VM ne dépend donc plus du déploiement d’une même paire sur chaque hôte.
La convention de nommage inclut aussi l’environnement et le rôle : kub-<env>-<role><digit>. Il est ainsi plus facile d’identifier la fonction de chaque VM dans l’interface Proxmox.
Le placement s’appuie sur la mémoire disponible sur les nœuds Proxmox en ligne. Les VM du control plane sont réparties sur des hôtes distincts disposant de suffisamment de mémoire libre, tandis que les workers sont placés en fonction de la capacité restante. Ce placement a lieu au moment du provisionnement, il ne s’agit pas d’un rééquilibrage continu des VM en cours d’exécution.
Une fois le placement calculé, le projet transmet les attributs de chaque VM au module :
module "pve_vm" {
  source    = "../../modules/pve_vm"
  for_each  = local.vm_list
  node_name = each.value.node_name
  vm_name   = each.key
  vm_cpu    = each.value.vm_cpu
  vm_ram    = each.value.vm_ram
  vm_vlan   = each.value.vm_vlan
  vm_tags   = ["${var.vm_env}"]
}
✅ Je teste d’abord le déploiement depuis bastion avec un master et deux workers. Tout fonctionne comme prévu, je passe donc à l’exécution depuis Semaphore.
📝 Le projet Terraform complet est disponible dans mon dépôt homelab.
Choisir les paramètres de déploiement dans Semaphore
Je crée un modèle de tâche Semaphore pour le projet Terraform et expose ses variables dans un formulaire. Après avoir remanié les paramètres, je peux choisir l’environnement ainsi que le nombre, le CPU, la RAM et le VLAN des masters et des workers.
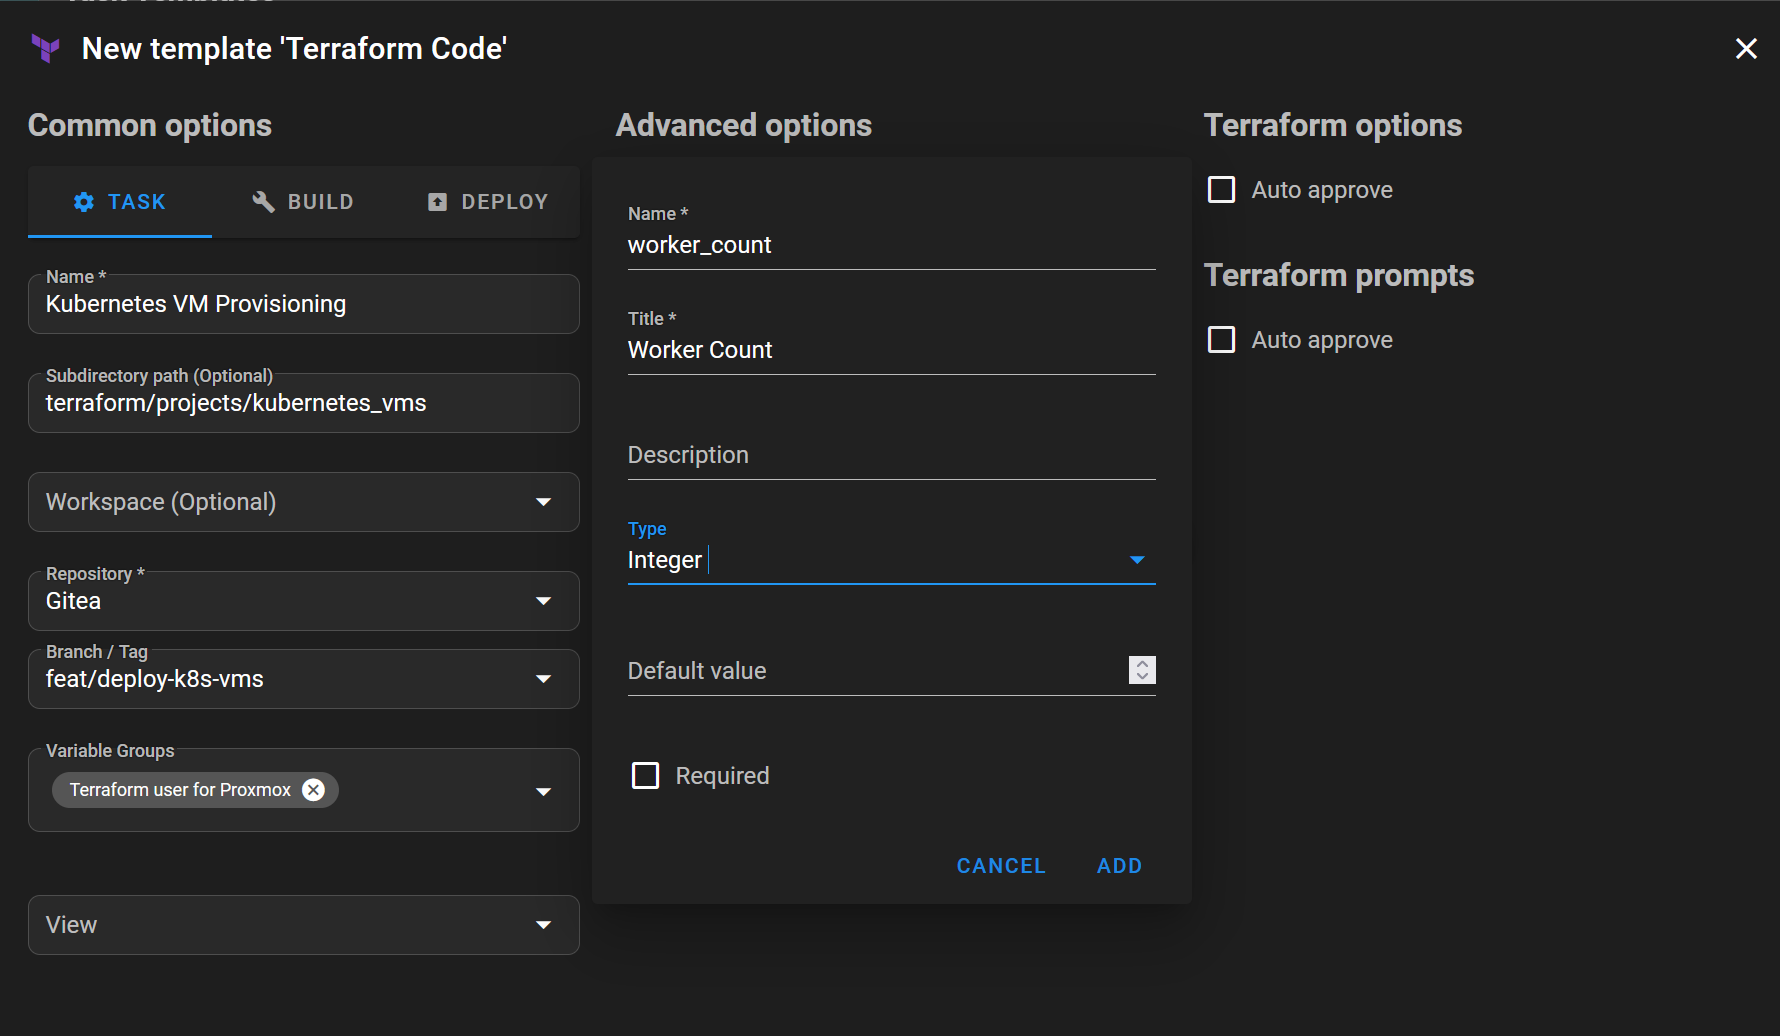
Le projet utilise vm_env pour l’environnement, et des variables master_* et worker_* distinctes pour les paramètres de chaque rôle. Par exemple, master_count détermine le nombre de VM du control plane, tandis que worker_ram définit la mémoire des workers.
Il faut garder à l’esprit une différence d’unité : les valeurs des paramètres master_ram et worker_ram sont en GiB, tandis que les valeurs de repli dans vm_attr sont en MiB. Terraform convertit les paramètres en MiB en interne avant de calculer le placement et de créer les VM.
Pour les paramètres secrets, j’utilise les variables d’environnement de Semaphore. Terraform lit les variables d’entrée depuis des variables d’environnement préfixées par TF_VAR_ ; la variable Terraform proxmox_api_token est donc fournie sous le nom TF_VAR_proxmox_api_token.
J’ai également besoin d’identifiants SSH pour cette configuration Semaphore, plutôt que de l’approche par clé SSH utilisée dans l’ancien projet semaphore-vms.
✅ Le provisionnement des VM fonctionne depuis Semaphore. Il me reste à faire cibler ces VM par Ansible sans maintenir une liste d’hôtes séparée.
Utiliser l’état Terraform comme inventaire Ansible
Terraform connaît déjà les machines qu’il a créées. Je veux qu’Ansible utilise ces informations plutôt que de recopier les noms et les adresses des VM dans un autre inventaire.
Le projet Terraform déclare les groupes et les hôtes de l’inventaire avec le provider Ansible :
resource "ansible_group" "vm_groups" {
  for_each = local.roles
  name     = each.key
}

resource "ansible_host" "vm_hosts" {
  for_each = module.pve_vm
  name     = each.key
  variables = {
    ansible_host = each.value.vm_ip
  }
  groups = [local.vm_list[each.key].vm_role]
}
Chaque hôte reçoit l’adresse IP renvoyée par le module VM et appartient au groupe correspondant à son rôle, master ou worker. Ces ressources d’inventaire sont enregistrées dans l’état Terraform.
Côté Ansible, j’utilise la collection cloud.terraform et son plugin d’inventaire terraform_provider. La configuration de l’inventaire pointe vers le répertoire du projet Terraform dans Semaphore :
---
plugin: cloud.terraform.terraform_provider
project_path:
  - /tmp/semaphore/project_1/repository_1_template_7/terraform/projects/kubernetes_vms
Ce chemin est propre au checkout Semaphore de mon installation. Ce n’est pas un chemin générique à reprendre tel quel ailleurs ; une exécution locale doit pointer vers son propre répertoire de projet Terraform.
J’ajoute cloud.terraform à collections/requirements.yml pour que Semaphore puisse installer la collection. Avant d’écrire le rôle de préparation des nœuds, je crée un playbook simple qui se contente d’exécuter un ping Ansible sur les hôtes.
✅ Le test fonctionne. Semaphore peut construire l’inventaire à partir de l’état Terraform et Ansible peut joindre les VM provisionnées.
⚠️ Il y a toutefois une limite importante : dans cette configuration, terraform.tfstate se trouve dans le checkout temporaire du conteneur Semaphore. Si le conteneur est recréé, cet état peut être perdu. L’intégration de l’inventaire fonctionne, mais elle ne garantit pas la persistance de l’état. Il faudra mettre en place un stockage durable avant de s’appuyer sur ce workflow pour des reconstructions répétées.
Préparer les nœuds avec Ansible
Une fois l’inventaire fonctionnel, je crée le rôle k8s_node et un petit playbook k8s_node.yml qui l’applique :
---
- name: Prepare Kubernetes nodes
  hosts: all

  roles:
    - role: k8s_node
Le rôle est réparti dans plusieurs fichiers de tâches : paramètres système, paquets, containerd et pare-feu.
Les tâches système désactivent le swap à l’exécution et tentent de commenter les entrées de swap dans /etc/fstab. Elles chargent et rendent persistants les modules kernel overlay et br_netfilter, puis configurent le filtrage du bridge et le forwarding IPv4.
Les tâches liées aux paquets ajoutent le dépôt Kubernetes, installent kubelet et kubeadm, puis bloquent la mise à jour de ces paquets. Les tâches containerd installent le runtime, génèrent sa configuration si elle n’existe pas, activent SystemdCgroup, puis redémarrent et activent le service.
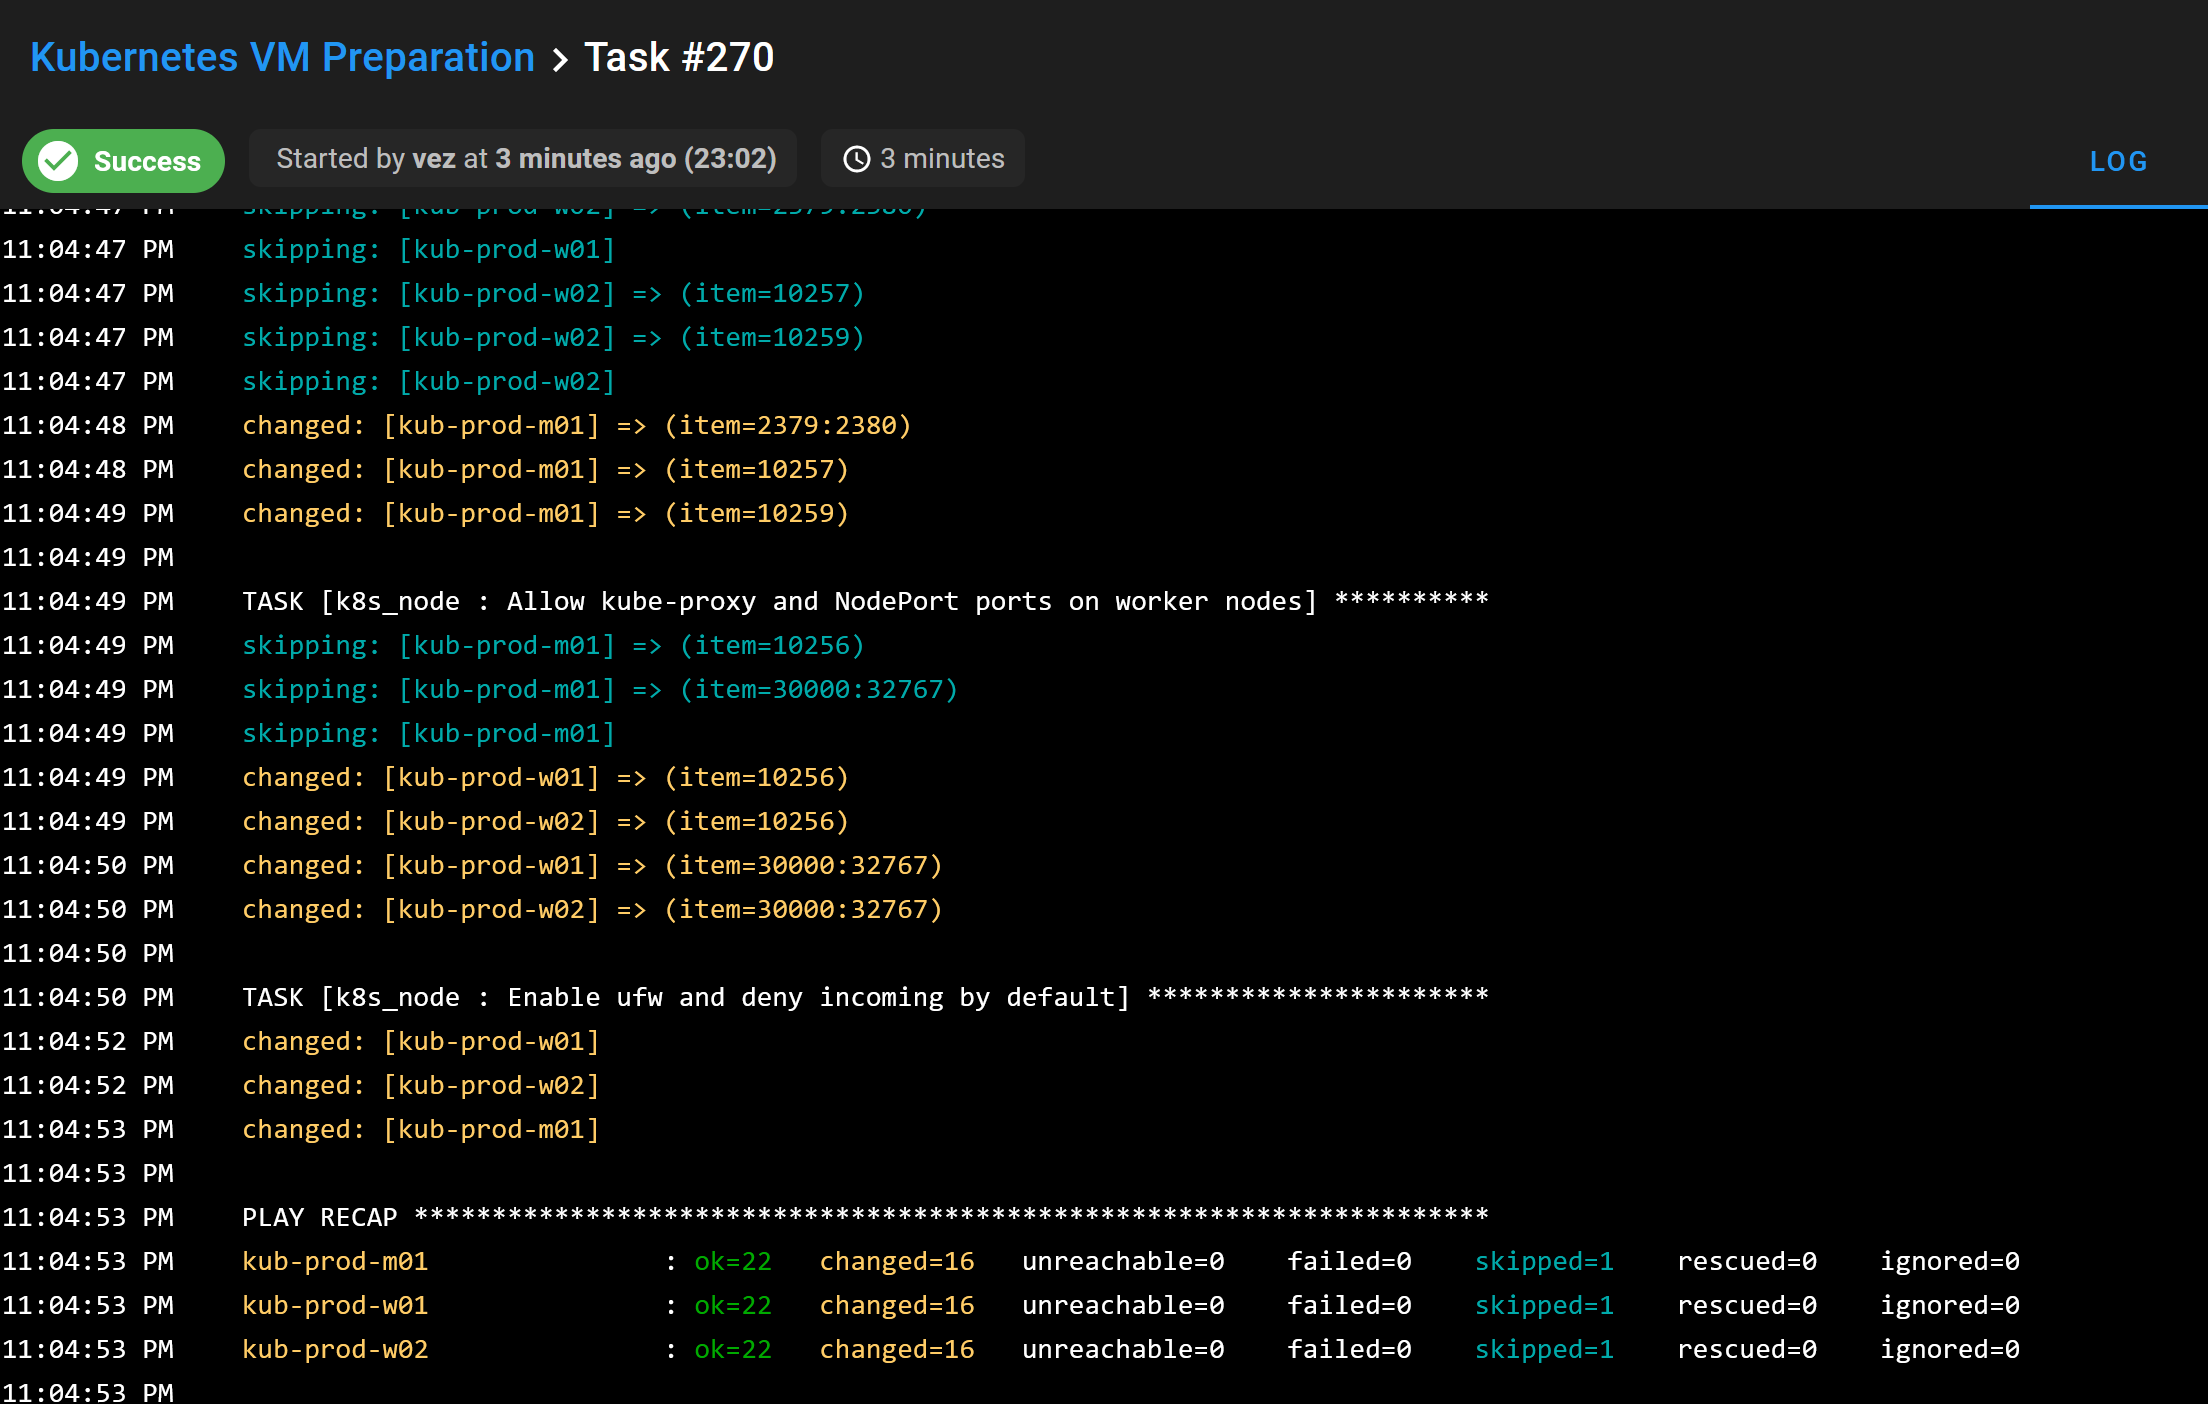
⚠️ Pour le pare-feu, le rôle applique des règles UFW selon les groupes de l’inventaire. Les nœuds du control plane reçoivent les règles correspondantes, et les workers celles qui leur sont destinées. Le sous-réseau source est configurable et le trafic entrant est refusé par défaut. Ces règles doivent correspondre au réseau utilisé par les nœuds ; elles ne constituent pas une configuration universelle pour tous les clusters.
Les groupes Terraform sont utiles au-delà du simple inventaire des machines. Ansible peut distinguer les rôles des nœuds sans autre correspondance à maintenir manuellement.
Je crée un modèle de tâche Semaphore appelé Kubernetes VM Preparation pour exécuter le playbook avec cet inventaire.
📝 Le projet Ansible et son rôle sont également disponibles dans le dépôt.
Où je m’arrête pour l’instant
La sélection d’un environnement dans le formulaire fonctionne, mais la méthode actuelle ne me permet pas de gérer plusieurs environnements indépendamment. Modifier la variable d’environnement ne revient pas à attribuer à chaque environnement son propre état Terraform.
Les workspaces Terraform pourraient être une solution plus tard. Je n’ai pas implémenté ni testé cette approche dans ce projet ; pour l’instant, le workflow reste limité à un seul environnement à la fois.
J’arrête aussi l’automatisation avant le bootstrap du cluster. Le playbook prépare les nœuds ; il n’exécute ni kubeadm init ni kubeadm join, et il n’installe pas le CNI. À ce stade de la migration, ces étapes restent manuelles.
✅ À la fin du projet, je déploie six VM avec Terraform et les configure avec Ansible. Elles sont prêtes à accueillir la création du cluster, mais aucun cluster Kubernetes n’a encore été bootstrapé.
Conclusion
🚀 J’ai maintenant six VM déployées avec Terraform et préparées avec Ansible via Semaphore. En utilisant l’état Terraform comme inventaire, je n’ai pas besoin de recopier leurs noms, leurs adresses et leurs rôles dans une liste d’hôtes séparée.
Le stockage temporaire de l’état et l’absence d’environnements indépendants restent à résoudre. Pour l’instant, je m’arrête aux machines préparées et je passe au bootstrap Kubernetes manuel, comme prévu dans la feuille de route de migration.